페르소나가 필요해 : 프레젠터 개발기
제 얼굴을 본뜬 SVG 프레젠터를 만들고, 프로그래머블 API와 TTS를 연동해 릴스 자동화 시스템에 넣었습니다. 팔과 손을 움직이던 첫 프로토타입부터 얼굴의 인상, 안경과 옷깃, 음성에 맞춘 동작을 다듬기까지 AI와 함께 겪은 시행착오를 정리했습니다.

프레젠터는 제 콘텐츠 안에서 말하는 저의 또 다른 모습, 페르소나입니다. 다른 릴스 영상을 보다가 문뜩, 화자가 화면에 나타나는 것이 중요할 수 있겠다는 생각이 들었습니다. 대부분 자신의 모습을 녹화하곤 했습니다.
하지만, 저는 스스로 얼굴을 드러내고 싶지는 않았습니다. 그런 취향과 더불어 자동화에도 큰 어려움이 있을 거라고 생각했습니다. 자동으로 생성한다고 하더라도, 제 사진을 기반으로 AI의 도움을 받아 생성해야 하기 때문입니다. 반면, 그림을 통한 프로그램 제어를 도입하면 AI는 명세만 작성하고 실제 프레임은 적은 비용으로 계산할 수 있을거라고 생각했습니다.
그 결과로, 제 얼굴 딴 그림을 바탕으로 코드로 표정과 동작을 제어하고 TTS 음성에 맞춰 입과 고개를 움직이는 SVG 프레젠터를 만들었습니다. React 컴포넌트와 프로그래머블 API로 구성해 블로그 글을 릴스로 옮기는 자동화 시스템에 넣었습니다.
API로 눈 깜빡임, 눈썹, 입 모양, 고개 끄덕임을 시간에 따라 제어할 수 있습니다. TTS 연동에서는 최종 음성의 단어별 타임스탬프를 받아 말하는 구간에 입과 고개를 움직이고, 쉬는 구간에는 입을 닫도록 했습니다. 프레젠터는 본문 장면이 바뀌어도 화면 오른쪽 아래에 머물며 내용을 전달합니다.
아래는 이 프레젠터를 AI와 함께 어떻게 개발했는지에 대한 개발기입니다.
내 사진을 움직일 수 있는 캐릭터로
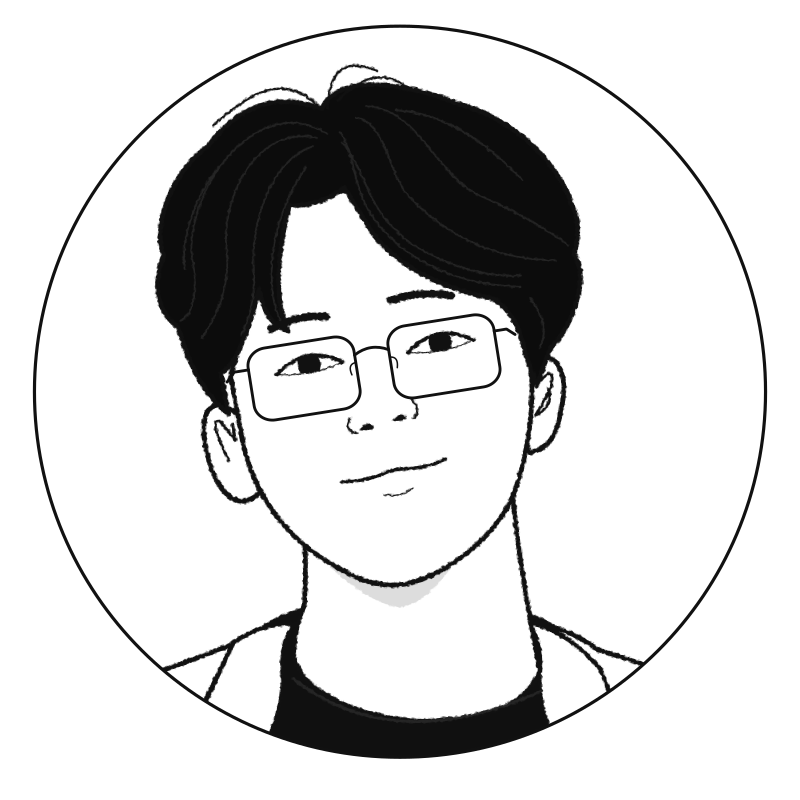
출발점은 제 사진이었습니다. 안경과 머리 모양처럼 저를 알아볼 수 있는 특징을 남기고, 흑백 선화로 표현한 캐릭터를 만들었습니다. 캐릭터 시트에는 손을 모은 모습, 설명하는 모습, 턱에 손을 댄 모습이 담겼습니다.
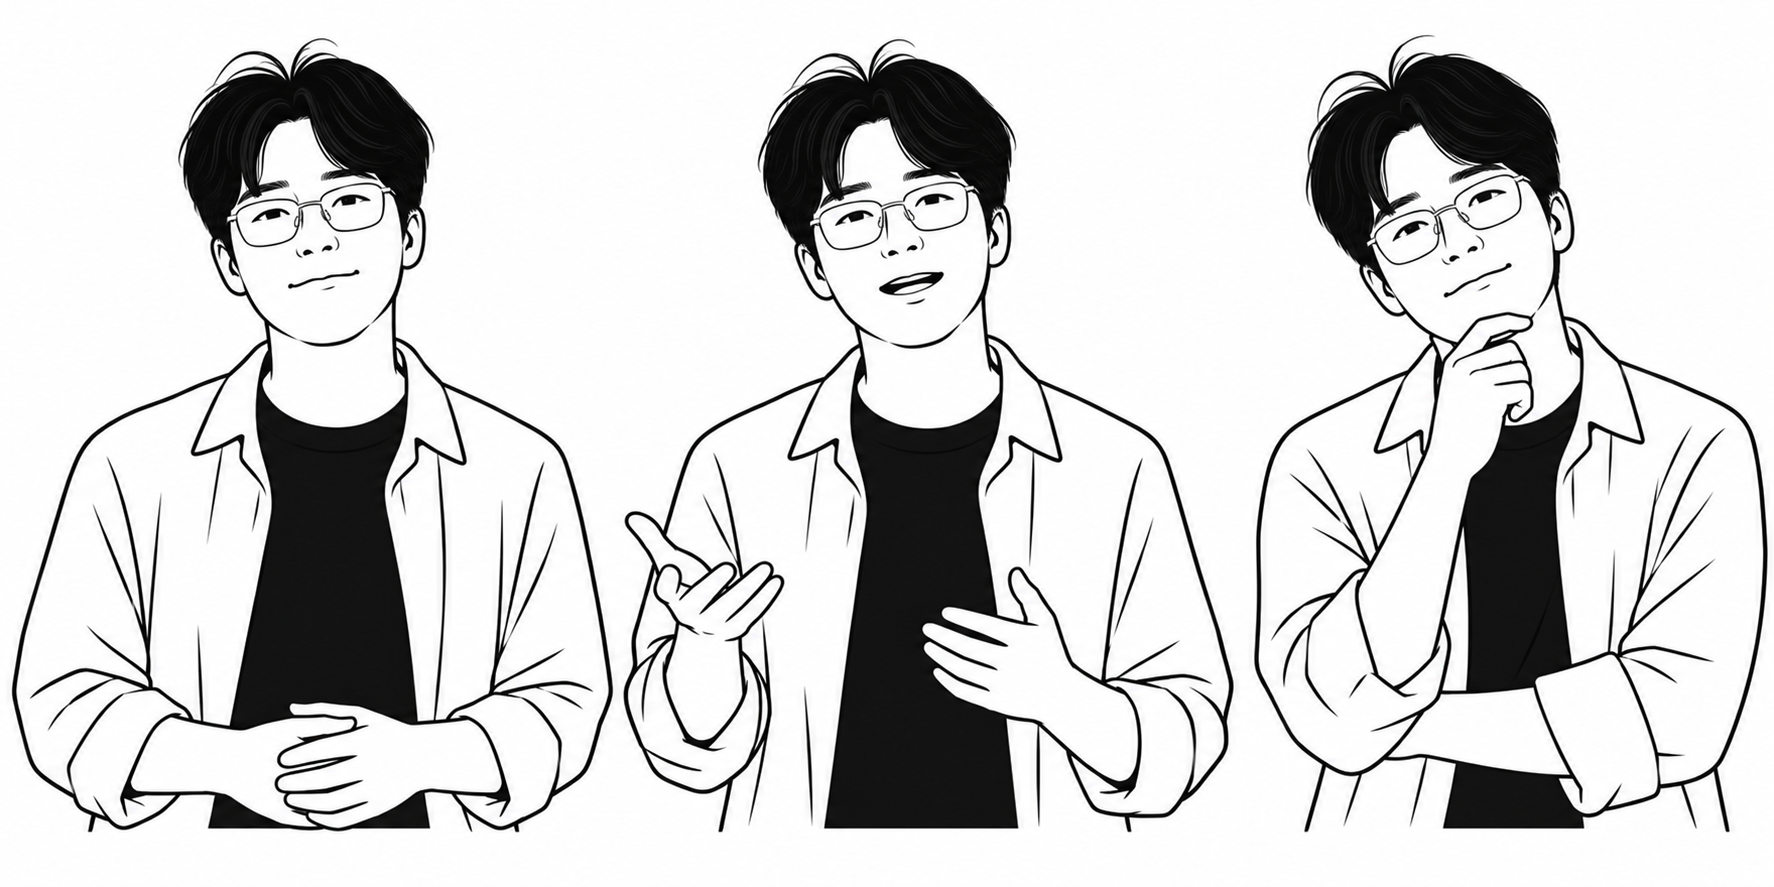
움직임을 제어하기 위해서는 별도의 구조가 필요했습니다. 구현에서는 참고 이미지를 바탕으로 SVG 경로를 다시 그리고, 얼굴과 몸의 부위를 React 컴포넌트와 그룹으로 나눴습니다. 원본 이미지의 픽셀을 그대로 잘라 움직이는 방식과는 차이가 있었고, 이 차이 때문에 나중에 그림을 다시 수정해야 했습니다.
SVG로 다시 그리면 눈과 입, 고개를 코드로 제어할 수 있습니다. 그 대신 원본에서 좋아했던 비율과 선을 다시 표현해야 합니다. ‘안경을 쓴 같은 사람’이라는 특징을 옮기는 것만으로는 충분하지 않았습니다. 얼굴의 길이와 눈 모양, 머리카락의 흐름이 달라지면 전체적인 인상도 바뀌었습니다.
처음에는 팔과 손까지 움직였습니다
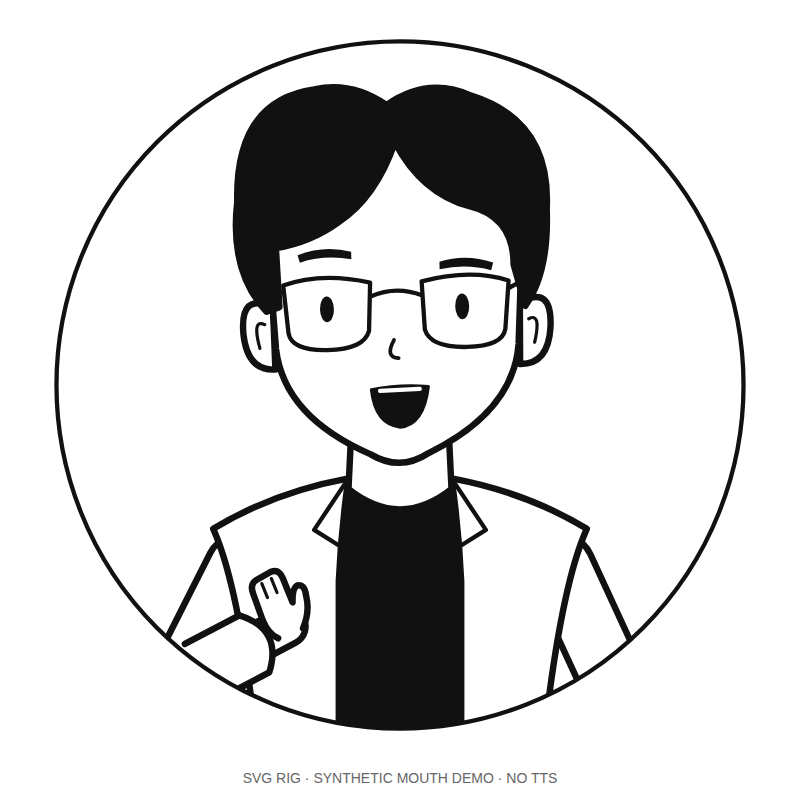
초기 프로토타입에는 몸통과 팔, 손이 있었습니다. 어두운 배경에서는 검은 머리와 옷의 윤곽이 묻히는 문제가 있어 실루엣이 드러나도록 수정했습니다. 이후에는 흰 배경의 원형 바스트 형태로 정리했습니다.
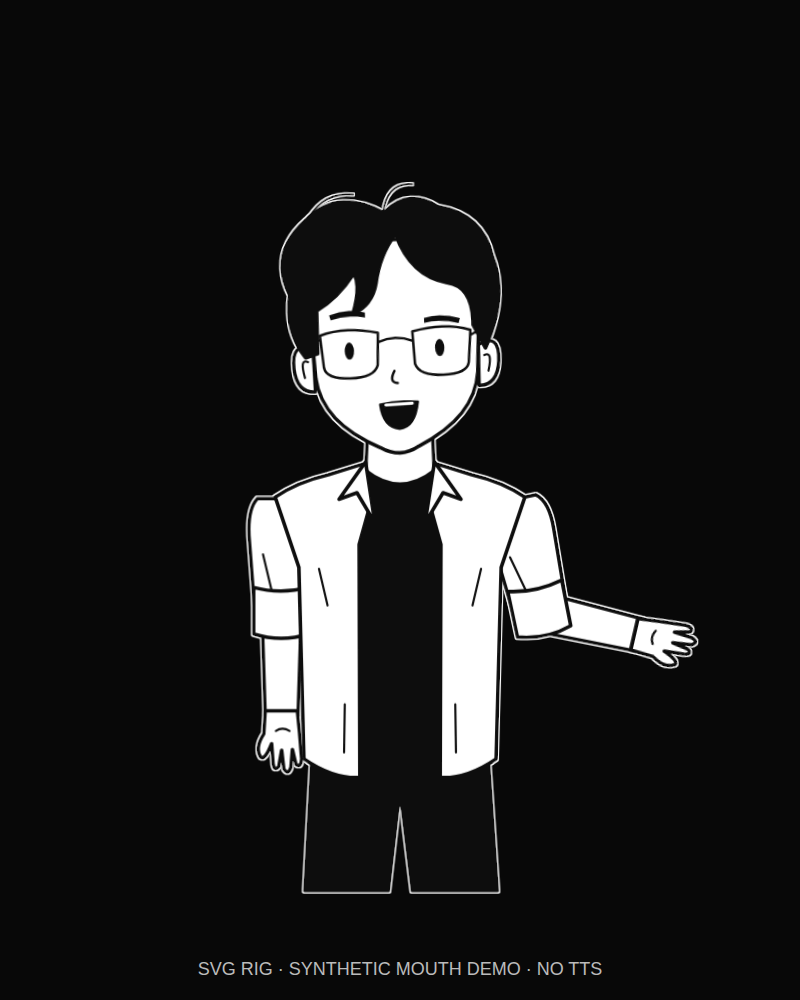
팔의 동작도 개선했습니다. 관절 각도를 각각 조정하던 방식에서 손의 목표 위치를 정하고 어깨와 팔꿈치의 각도를 계산하는 방식으로 바꿨습니다. 두 개의 뼈로 연결된 팔을 계산하는 역기구학, IK를 적용했습니다.
손이 목표 지점으로 움직이더라도 위팔과 아래팔의 길이가 유지되고, 팔꿈치가 정해진 방향으로 굽혀져야 했습니다. 너무 먼 목표에는 도달 범위를 제한했습니다. 한 번에 한쪽 손을 움직이고, 동작의 시작과 끝을 완만하게 만들고, 손목이 조금 늦게 따라오도록 조정했습니다.
여기까지는 팔과 손을 어떻게 움직일지 해결하는 과정이었습니다. 하지만 이후 수정에서는 손을 화면에서 없앴습니다. 현재 캐릭터가 다루는 동작의 범위를 얼굴과 고개 쪽으로 좁힌 것입니다. 기존 손 관련 입력은 호환성을 위해 남았지만, 화면에는 손을 그리지 않도록 바뀌었습니다. 구현 기록: PR #118
기능이 늘어나는 동안 그림의 인상도 달라졌습니다
손을 없앤 버전에서는 둥근 눈썹과 부드러운 명암을 적용했습니다. 표정과 입 모양도 여러 상태로 나눴습니다. 기본·미소·호기심 등의 표정과, 닫힌 입 및 오,이,아,음 형태를 확인하는 시트를 만들었습니다.
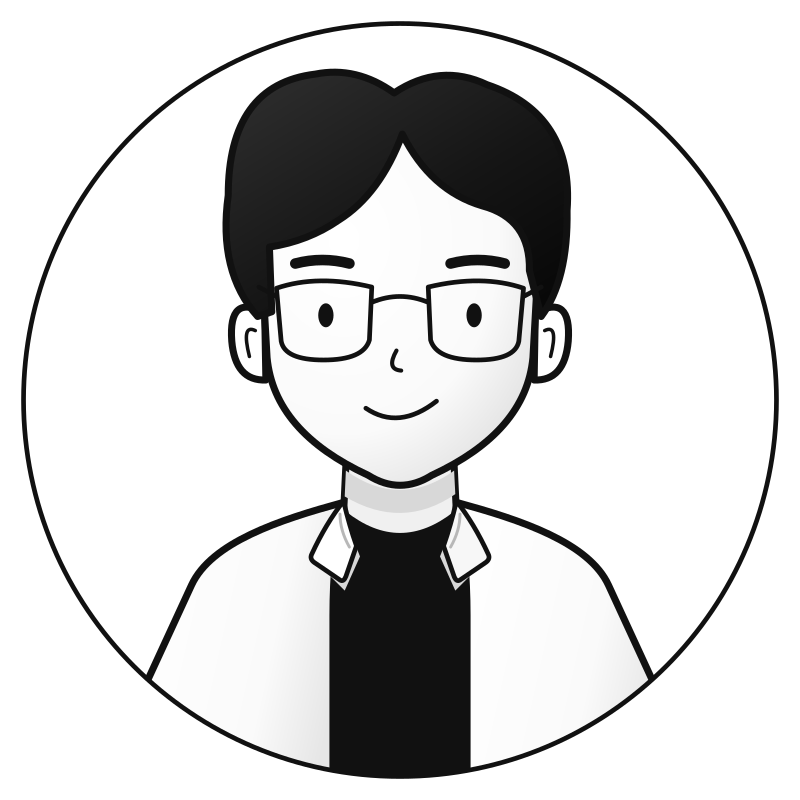
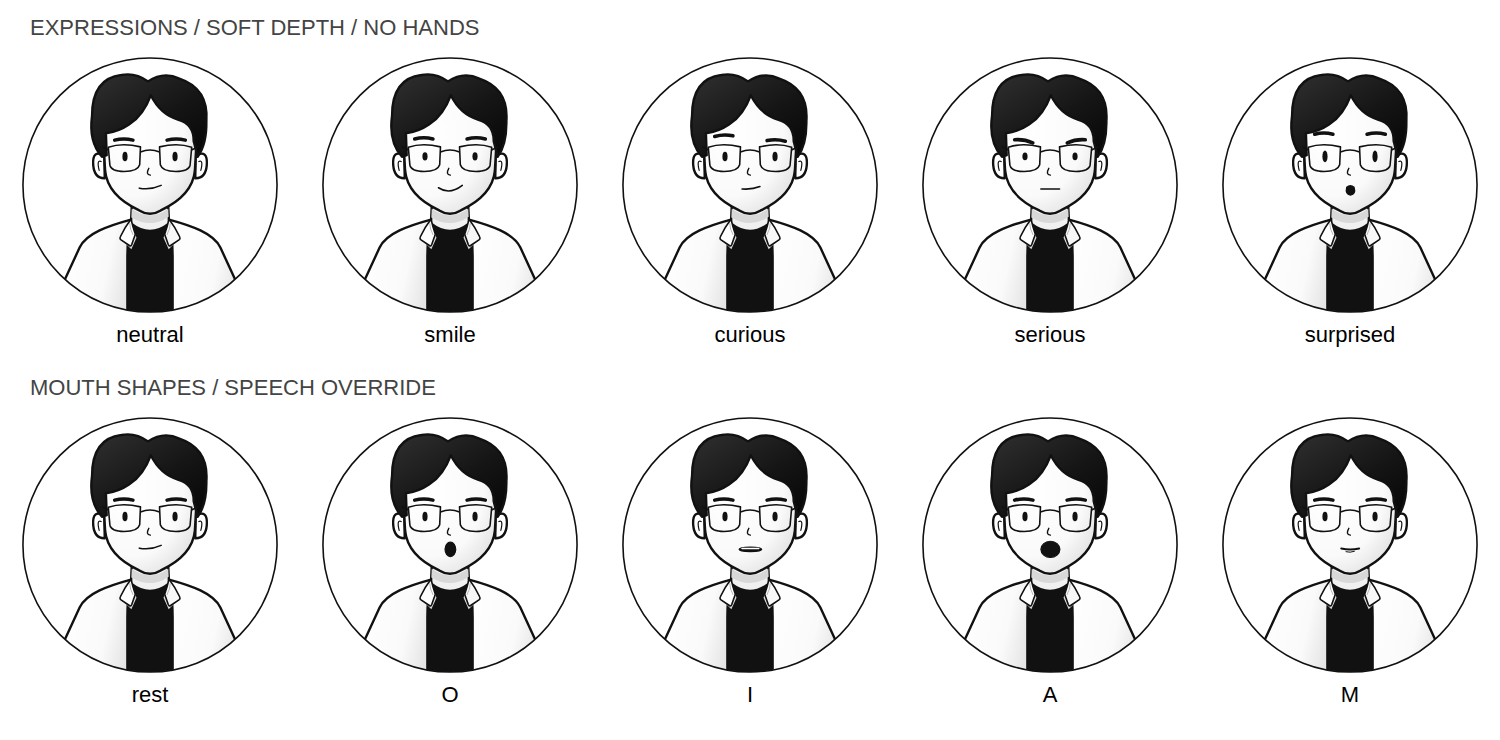
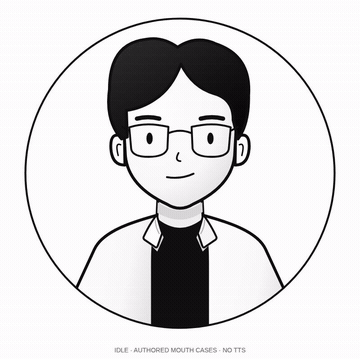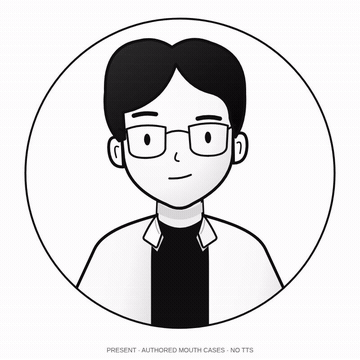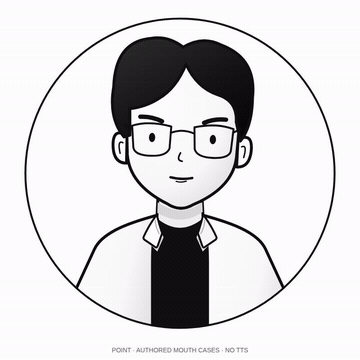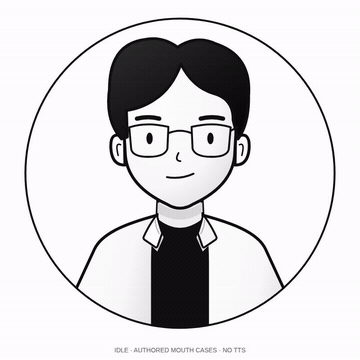
그런데 제가 원했던 그림과는 거리가 생겼습니다. 대화 중에 최초 이미지를 다시 꺼내 “이 느낌으로 다시 돌아가고 싶다”고 요청했습니다. 표정과 동작을 더 많이 제어할 수 있게 됐어도, 캐릭터의 인상이 마음에 들지는 않았습니다.
이후 수정에서는 길쭉한 얼굴 비율, 가늘고 긴 눈, 흐르는 머리카락 선을 다시 살렸습니다. 처음 좋아했던 초상의 느낌을 SVG 안에서 복원하는 작업이었습니다. 같은 원형 바스트 형식을 유지하더라도 눈과 머리카락, 턱선이 바뀌자 결과물의 인상은 크게 달라졌습니다.
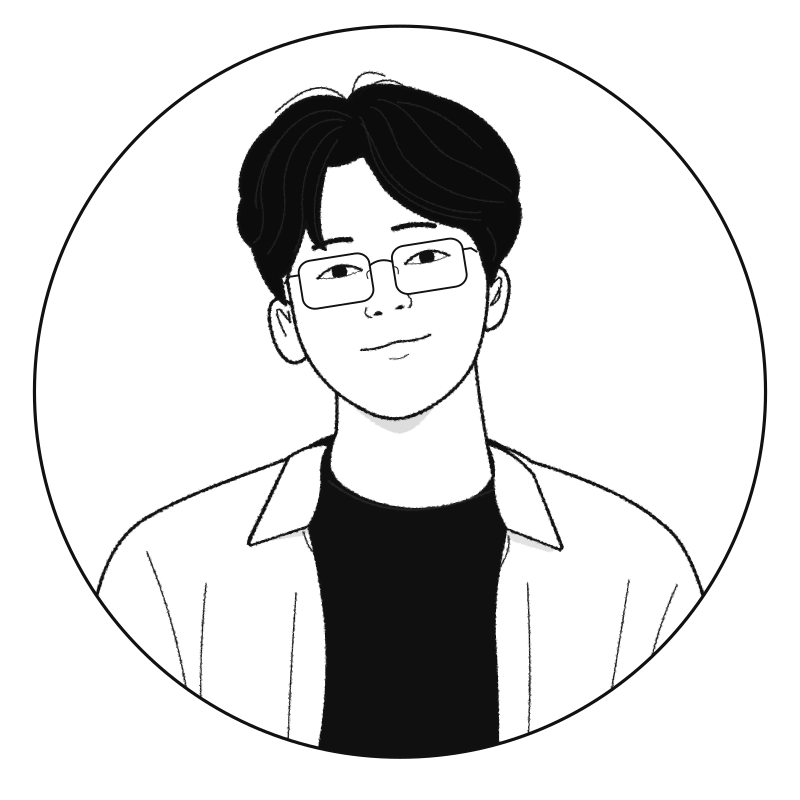
이 과정에서 기준 이미지를 계속 남겨 두는 일이 중요해졌습니다. 수정된 결과만 보고 다음 요청을 이어 가면, 어느 순간 무엇을 보존하려 했는지 놓칠 수 있었습니다. 이전 이미지를 다시 펼쳐 놓으니 돌아가야 할 방향이 분명해졌습니다.
고개, 눈, 눈썹, 입을 따로 움직였습니다
원래 그림의 인상으로 돌아온 뒤 요청한 움직임은 작았습니다. 고개를 자연스럽게 끄덕이고, 눈을 깜빡이고, 눈썹과 입을 조금 움직이는 정도였습니다.
구현에서도 이 동작들을 독립적으로 제어하도록 나눴습니다. 어깨는 고정하고 고개와 목이 움직이며, 눈 깜빡임과 양쪽 눈썹을 따로 조절할 수 있게 했습니다.
개발용 입력과 콘텐츠 작성용 입력도 구분했습니다. 스토리보드를 만들 때마다 관절 좌표나 눈꺼풀 값을 지정하는 것은 부담이 큽니다. 설명하거나 강조하는 행동, 미소나 호기심 같은 표정을 지정하면 그에 맞는 세부 동작으로 이어지도록 구성했습니다.
같은 시점을 다시 렌더했을 때 같은 자세가 나오는 것도 조건이었습니다. 영상은 처음부터 순서대로 재생할 때도 있지만, 특정 프레임만 확인하거나 여러 구간을 나누어 렌더할 때도 있습니다. 동작을 시간의 함수로 계산해 앞뒤로 이동해도 같은 결과를 얻도록 했습니다.
실제 SVG를 렌더한 600×600, 24fps 영상입니다. 입 모양의 시점은 수동으로 작성한 데모이며, 이 영상에는 실제 TTS 정렬이 적용되지 않았습니다. 얼굴을 1.5배 확대하기 전 버전입니다.
안경이 찌그러지고, 카라가 목 앞으로 나왔습니다
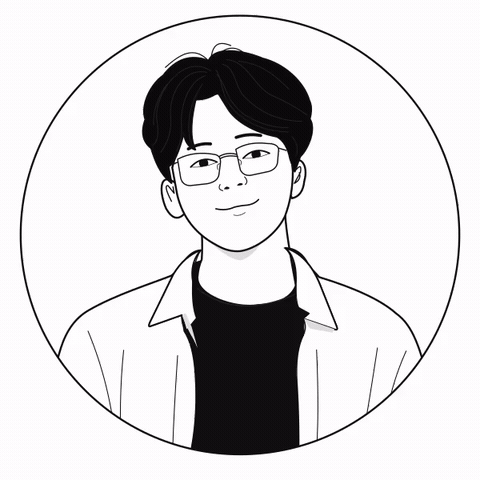
작은 동작을 넣고 형태를 다듬는 과정에서는 안경과 옷깃이 계속 눈에 들어왔습니다. 오른쪽 카라가 잘린 것처럼 보이는 부분을 정리해 달라고 했고, 목 앞으로 카라가 튀어나온 부분도 다시 짚었습니다. 안경에는 “조금 더 공산품처럼 보이게, 찌그러지지 않게”라는 표현을 썼습니다.
안경은 같은 크기의 둥근 사각형 테 두 개와 연결부로 정리했습니다. 잉크 질감을 만드는 필터에서도 분리했습니다. 고개를 끄덕일 때 머리에는 작은 세로 축소가 들어가는데, 그 변형이 안경까지 찌그러뜨리지 않도록 반대 방향의 배율 보정을 적용했습니다. 안경은 머리를 따라 움직이면서 테의 비율을 유지하도록 했습니다.
옷깃은 형태와 겹치는 순서를 함께 수정했습니다. 카라의 시작점을 낮추고 목을 카라보다 앞에 그리도록 바꿨습니다. 좌우 카라는 끊기지 않는 닫힌 면으로 구성하고, 아래쪽 접힘 위에 그리도록 정리했습니다.
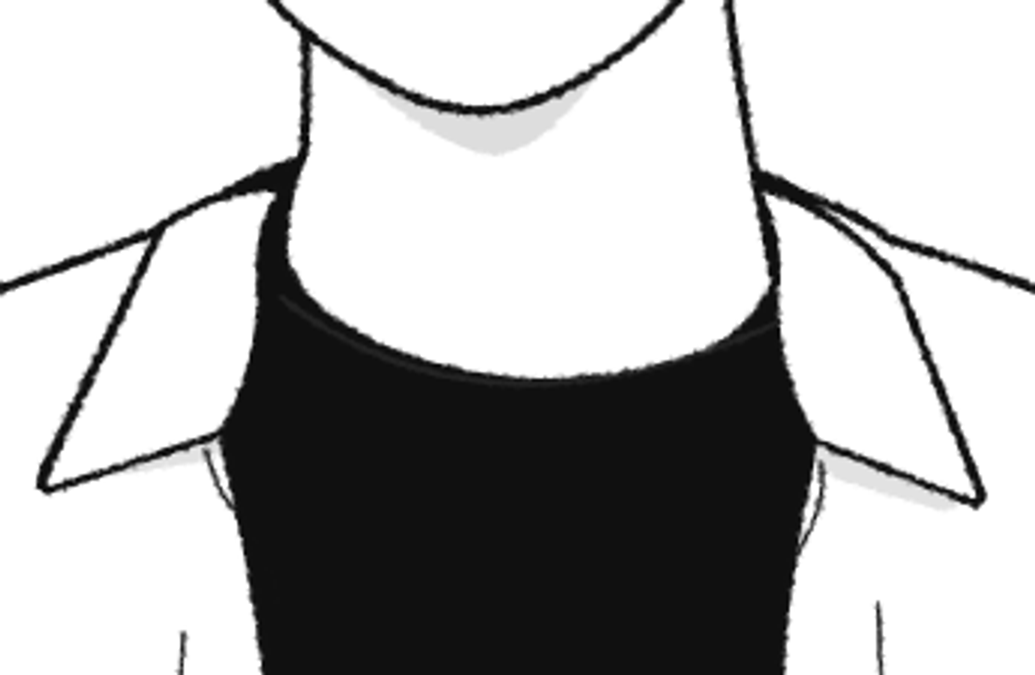
이런 문제는 ‘자연스럽게 해 달라’는 말만으로는 설명이 부족했습니다. 고개 변형이 안경에 전달되는 문제인지, 카라가 목보다 앞에 그려지는 문제인지 구분해야 했습니다. 피드백을 부위와 관계로 나누자 수정해야 할 코드도 더 분명해졌습니다.
선은 흔들리되, 형태는 유지해야 했습니다
선에 노이즈를 넣어 조금 자글자글한 느낌을 주고 싶었습니다. 나아가 프레임마다 노이즈를 바꿔 효과로 써 보자고 요청했습니다.
처음에는 고정된 잉크 질감을 넣었고, 이후에는 초당 8번 질감이 바뀌도록 수정했습니다. 영상의 모든 프레임에서 새 난수를 뽑는 대신, 시간으로 질감 프레임을 정하고 그 값에서 시드를 계산하도록 했습니다. 같은 시점으로 돌아가면 같은 선이 나타나게 만들기 위해서입니다.
질감의 적용 범위도 제한했습니다. 얼굴과 몸의 잉크 선에는 변화가 생기지만 안경, 흰 배경, 원형 테두리는 영향을 받지 않게 했습니다. 안경은 반듯하게 유지하면서 나머지 선에는 손으로 그린 듯한 질감을 더할 수 있었습니다.
그 과정에서 검증할 조건도 생겼습니다. 양쪽 안경테의 치수가 같은지, 안경의 상위 그룹에 노이즈 필터가 걸리지 않았는지, 목이 카라보다 앞에 그려지는지, 같은 시점의 잉크 질감이 재현되는지 등을 테스트로 확인했습니다. 시각적인 피드백 가운데 구조로 표현할 수 있는 부분을 코드의 조건으로 옮긴 셈입니다. 렌더 방법과 동작 명세
실제 페이지에 넣으니 또 다른 문제가 생겼습니다
캐릭터 단독 프리뷰 다음에는 영상 페이지 안에서 확인해야 했습니다. 초기에는 발표자가 크게 등장하는 전용 페이지를 만들었고, 이후에는 본문 우측 하단에 계속 표시하는 형태로 확장했습니다.
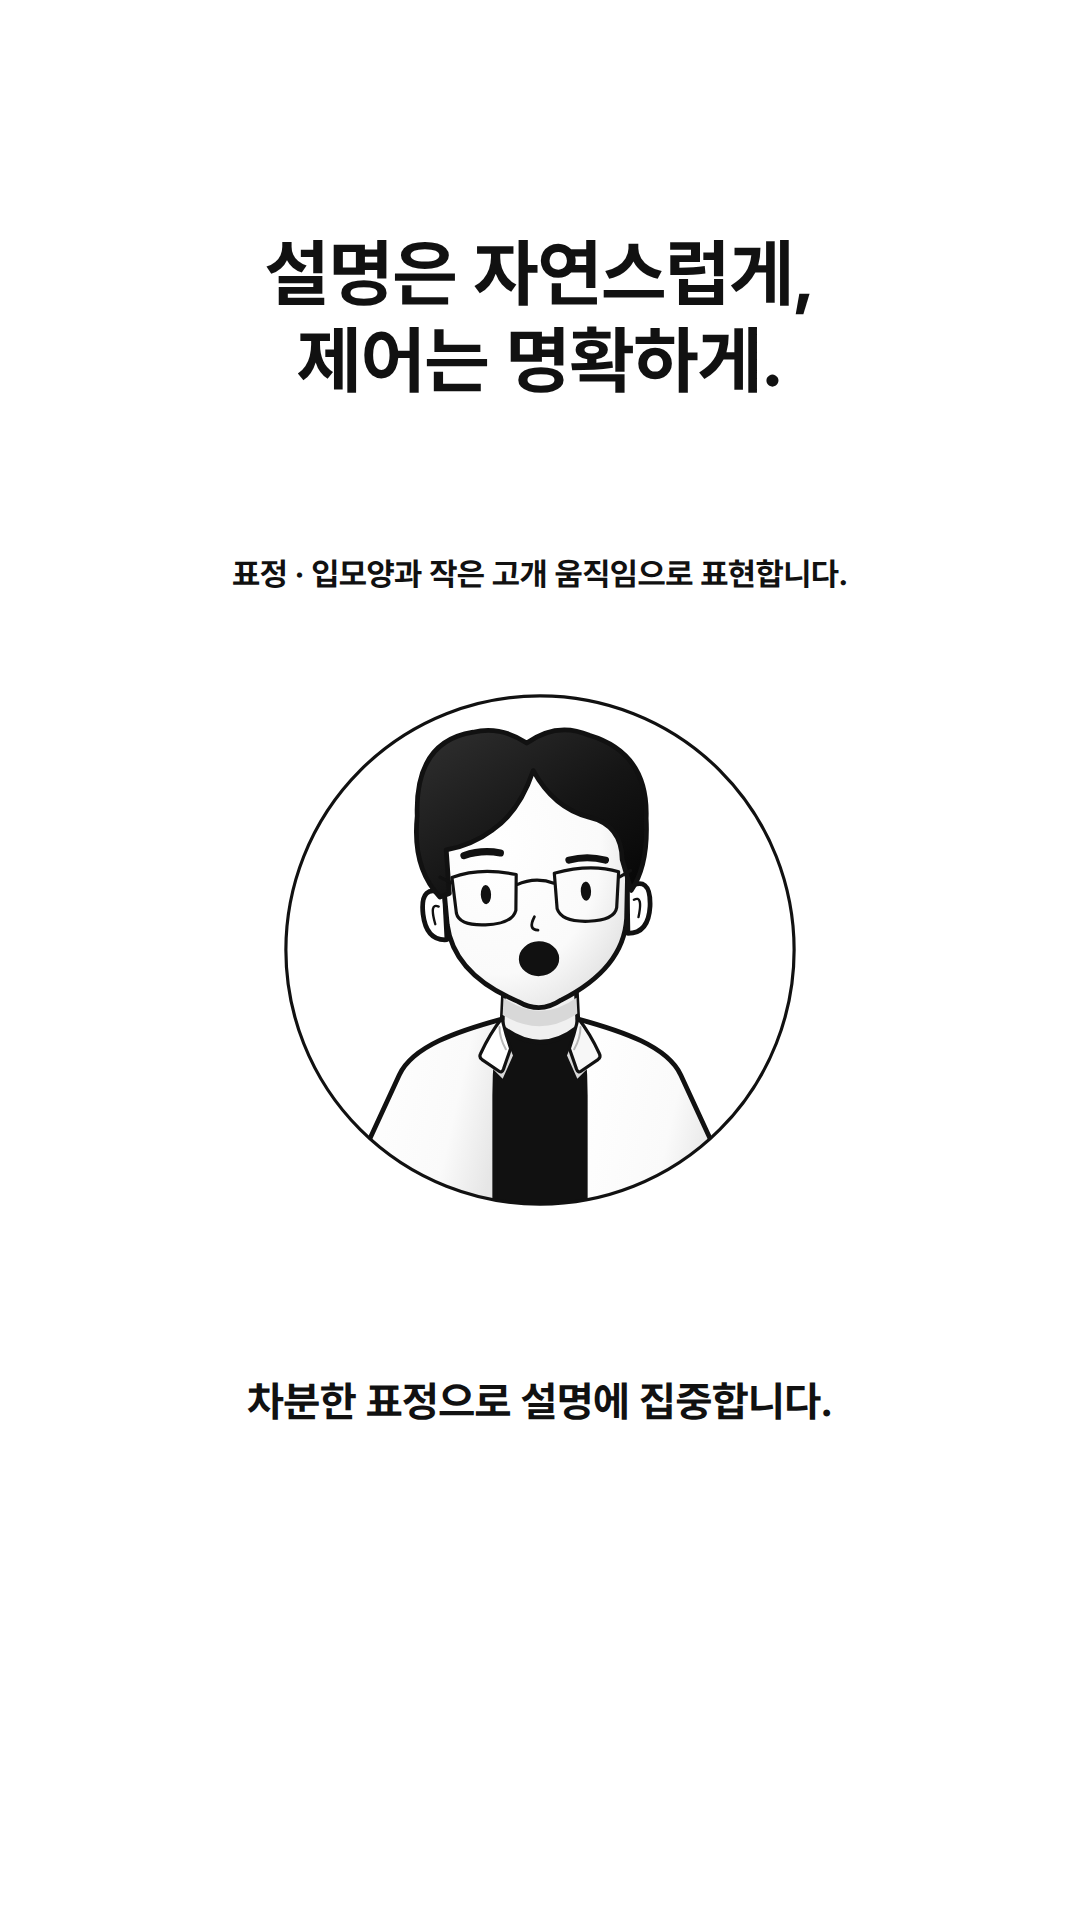
우측 하단에 둔다고 배치가 끝나는 것은 아니었습니다. 실제 렌더 결과를 검수하다가 제목이 들어오는 도중 발표자 영역과 닿는 문제를 발견했습니다. 정지한 최종 화면만 확인했다면 놓칠 수 있는 문제였습니다. 발표자 모드에서 제목 여백을 확보한 뒤 전체를 다시 렌더했습니다.
장면이 전환될 때 발표자까지 함께 사라지거나 흐려지는 것도 피해야 했습니다. 발표자를 장면 전환 효과 바깥에서 한 번 렌더해 위치와 크기를 유지하도록 구성했습니다. 두 렌더 테마에서 각 장의 결과와 전환의 시작·중간·끝을 따로 확인했습니다. 배치와 검수 기록: PR #119
얼굴 크기도 다시 조정했습니다. 확대를 여러 차례 조절한 뒤 원래 초상 대비 1.5배로 정리했습니다. 원형 테두리는 유지하면서 몸통이 더 잘리고 얼굴이 크게 보이는 구도입니다. 캐릭터를 작은 영역에 넣으려면 전신 프리뷰를 볼 때와는 다른 기준으로 구도를 잡아야 했습니다.
입이 움직이는 데모에서 음성에 맞춘 동작으로
초기 프리뷰의 입 움직임은 직접 지정한 시점에 따라 입 모양을 바꾸는 데모였습니다. 입 모양을 제어할 수 있다는 것은 확인했지만, 실제 발화에 맞추는 작업이 남아 있었습니다.
후속 변경에서는 최종 재생 속도를 적용한 TTS 파일을 기준으로 단어별 타임스탬프를 얻고, 그 시간에 맞춰 입과 고개가 움직이도록 연결했습니다. 단어 사이의 쉼에서는 입을 닫고, 발화 구간에는 고개를 가볍게 끄덕이도록 합니다. 단어 내부의 입 모양은 한글 음절을 바탕으로 근사합니다.
마지막 페이지의 동작도 바뀌었습니다. 앞선 버전에서는 공통 CTA까지 발표자를 유지했지만, 후속 변경에서는 본문에만 표시하고 공통 CTA가 시작되는 프레임부터 숨기도록 정리했습니다. 발표자가 등장하는 규칙에도 페이지의 역할에 따른 예외가 필요했습니다. 음성 연동과 CTA 수정: PR #120
프레젠터를 만들며
이번 작업은 팔과 손을 포함한 프로토타입에서 시작했습니다. 손을 없애고 표정에 집중했다가, 원래 좋아했던 그림의 인상을 다시 복원했습니다. 그다음에는 안경과 카라의 구조, 선의 질감, 얼굴 크기, 본문 배치와 음성 타이밍을 다뤘습니다.
이번 연구에서는 이정도로 만족하기로 했습니다. 결과물은 아직 성에 차지 않지만, 그것보다 이 프레젠터 아바타가 효과가 있는지 확인하는 것이 중요하기 때문입니다. 추후 기술을 더욱 확보해서 2.5D의 입체감 있게 움직이는 선화 아바타로 발전시켜보고 싶습니다.
READ NEXT
같은 주제의 글 더 보기
Spring·Kotlin 백엔드 구조를 다시 설계하며 UseCase, Domain, Repository의 책임과 상태 저장, 트랜잭션 경계를 정리한 기록입니다.
Read Entry

댓글 0
로그인 없이 익명으로 남길 수 있습니다.